Qwen-Image-2.1をRTX 5070で試した|導入方法・VRAM・文字描画・画像編集を検証
2026年9月に公開された Qwen-Image-2.1 を、VRAM 12GB の GeForce RTX 5070 で動かしました。導入に必要なもの、VRAM と生成時間の実測、人物・文字・画像編集の実際の出力をまとめます。
Qwen-Image-2.1 とは
Alibaba の Qwen チームが公開した、文章からの画像生成と画像編集を1つでこなすモデルです。公式のモデルカードによると、画像生成部分は 7B パラメータで、透過(RGBA)画像の生成、最大10枚の参照画像を使った編集、文字の描画の改善をうたっています。
ライセンスの注意: 非商用限定
ライセンスは Qwen Research License Agreement です。使えるのは研究・評価目的(Non-Commercial)に限られ、商用で使うには Qwen から別途ライセンスを受ける必要があると明記されています。生成した画像を販売する、仕事の成果物に使うといった用途では、ライセンス本文を確認してください。この記事は評価目的の検証です。
RTX 5070 での導入
必要なのは ComfyUI v0.37.0 以降です(2026年9月21日公開)。Qwen-Image-2.1 を動かすには、専用ノード「Text Encode Qwen Image 2.1」と「Qwen Image 2.1 Cache」が必要です。GitHub の各リリースのソースを確かめたところ、これらのノードが入ったのは v0.37.0 からで、v0.36.0 以前にはありません。古い版では、公式ワークフローを開いてもノードが見つからず、生成できません。
自分の ComfyUI の版を確かめる方法: ComfyUI を起動したときの黒い画面(ログ)に ComfyUI version: 0.37.0 のような行が出ます。画面上では、ノードを検索して「Text Encode Qwen Image 2.1」が出てくれば対応済みです。
筆者の環境の ComfyUI は 0.27 でした。この ComfyUI は動画生成(Wan 2.2)の作業にも使っているため、更新で既存のワークフローが動かなくなるのを避け、v0.37.0 を別のフォルダに新しく入れました。既存の ComfyUI をそのまま更新しても問題ない人は、更新するだけで構いません。別に入れる場合の手順は次のとおりです(Windows、Python 3.12、NVIDIA GPU の例)。
git clone --branch v0.37.0 https://github.com/Comfy-Org/ComfyUI.git ComfyUI-latest
cd ComfyUI-latest
python -m venv venv
venv\Scripts\python -m pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu128
venv\Scripts\python -m pip install -r requirements.txt
venv\Scripts\python main.py --port 8189
既存の ComfyUI(既定のポートは 8188)と同時に起動できるよう、ポートを 8189 に変えています。ただし GPU は共有なので、生成は片方ずつ行ってください。
モデルは、Comfy-Org が ComfyUI 向けにまとめた Comfy-Org/Qwen-Image-2.1 から、12GB に収まる int8 版を選びました。
| 種類 | ファイル | サイズ | 置き場所 |
|---|---|---|---|
| 本体 | qwen_image_2.1_int8_convrot.safetensors | 7.26GB | models/diffusion_models |
| テキストエンコーダー | qwen3vl_8b_int8_convrot.safetensors | 9.35GB | models/text_encoders |
| VAE | qwen_image_2.1_vae_bf16.safetensors | 0.68GB | models/vae |
設定は Comfy-Org の公式ワークフロー(Text to Image)の既定値のまま、25ステップ・CFG 1・euler + simple です。公式ワークフローにはプロンプトを書き直す拡張機能(別の 9.5GB のモデル)もありますが、既定では無効なので使っていません。
実測値(RTX 5070、VRAM 12GB、RAM 32GB): 生成中の VRAM 使用量は約10.2GB でした。1枚の生成時間は、896×1152 でも 1024×1024 でも約50秒(中央値。モデル読み込みを含む最初の1枚は約56秒)、画像編集は約65秒でした。
人物の生成(実写・アニメ)
当サイトのモデル比較記事と同じ共通プロンプトで、制服風の服を着た架空の20歳の女性を、全身の「引き」と顔の「接写」で生成しました。seed は 1001・2002・3003 の3種類で、選別はしていません。
実写
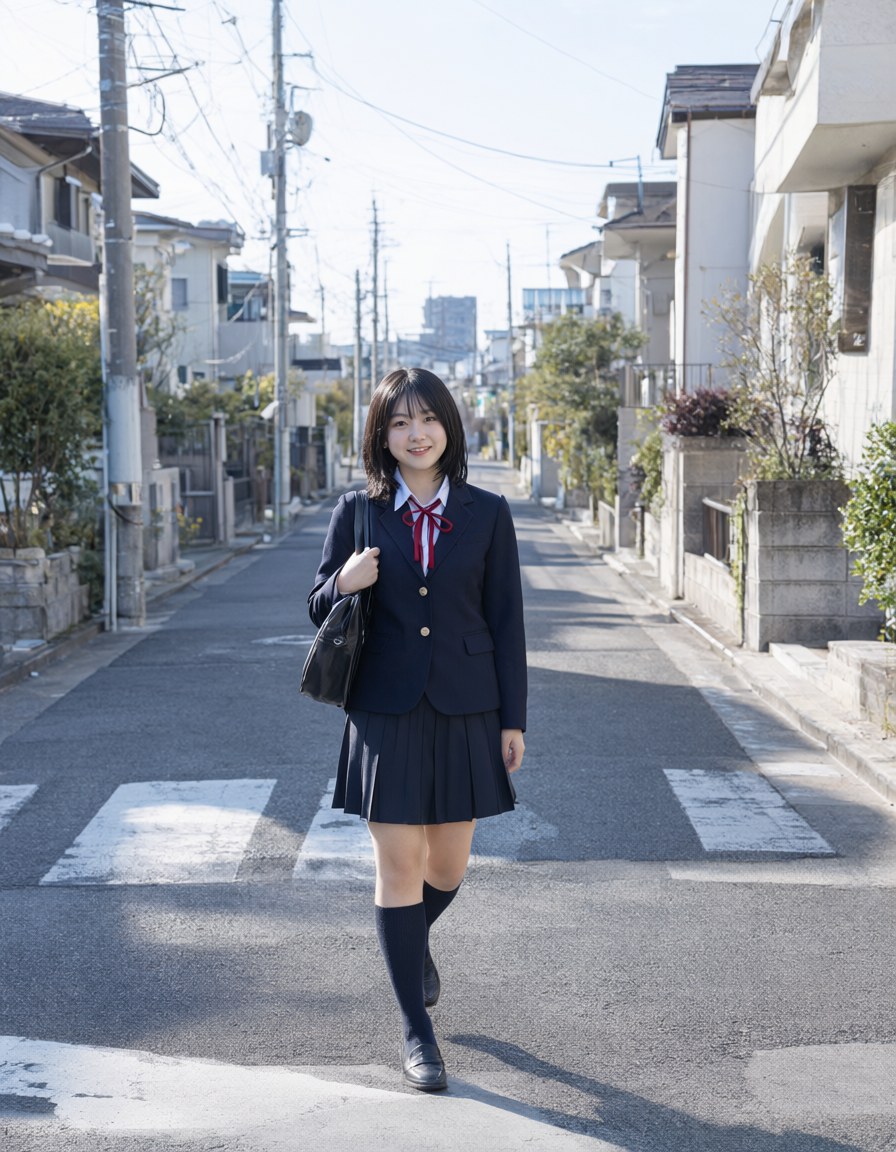
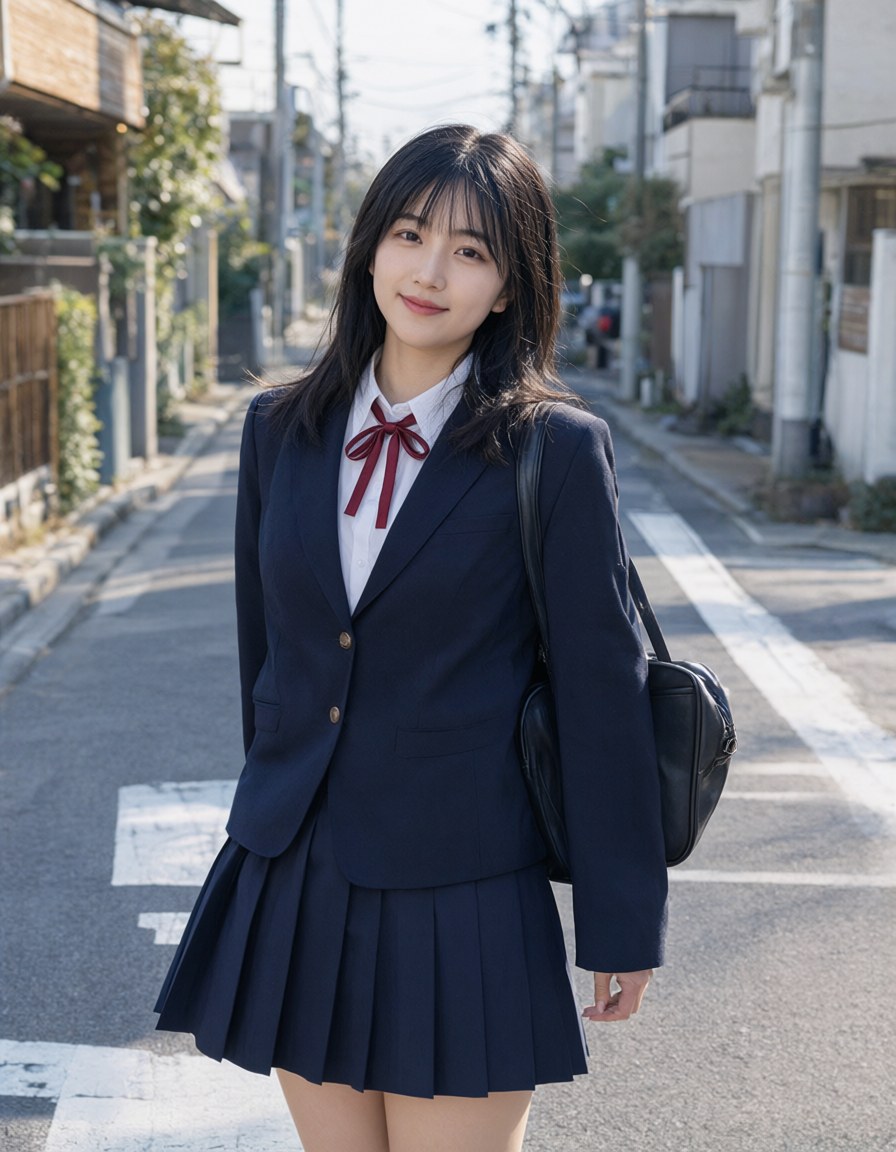
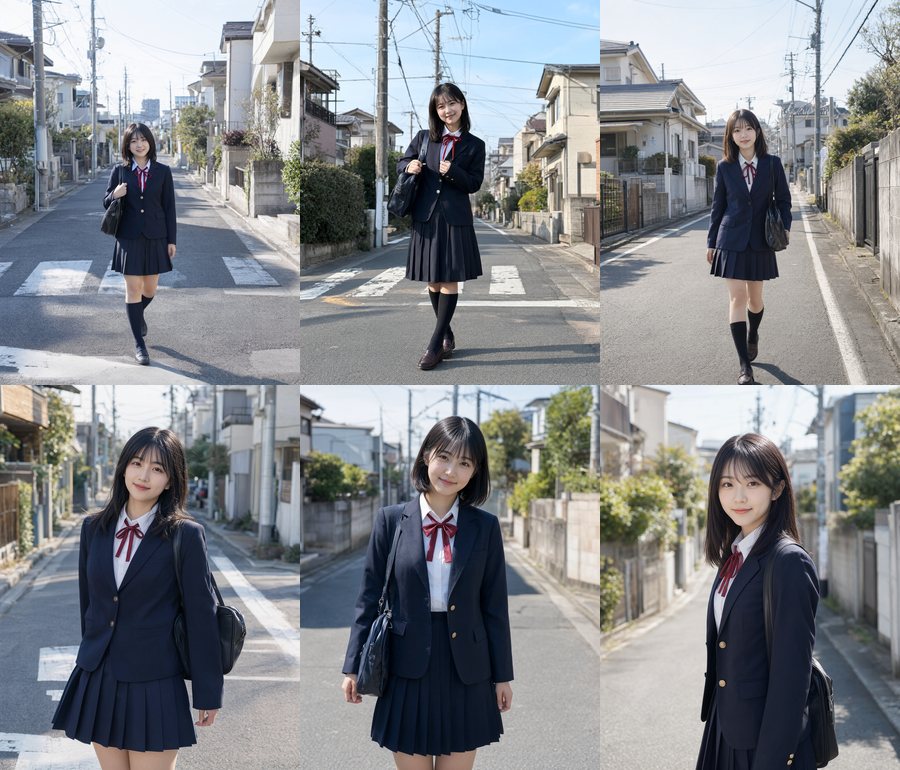
入力したプロンプト全文(実写)
引き:
photo, wide shot, full body, a fictional Japanese woman age 20, clearly an adult, wearing a school-uniform-style outfit: navy blazer, white shirt, red ribbon, knee-length navy pleated skirt, shoulder-length black hair, gentle smile, carrying a shoulder bag, fully clothed, modest, walking on a quiet residential street during a sunny morning commute, natural light, houses, utility poles, crosswalk接写:
photo, close-up portrait of the face and shoulders, a fictional Japanese woman age 20, clearly an adult, wearing a school-uniform-style outfit: navy blazer, white shirt, red ribbon, knee-length navy pleated skirt, shoulder-length black hair, gentle smile, carrying a shoulder bag, fully clothed, modest, looking at the camera, on a quiet residential street during a sunny morning commute, natural light, shallow depth of fieldネガティブ: なし(CFG 1 のため無効)
アニメ
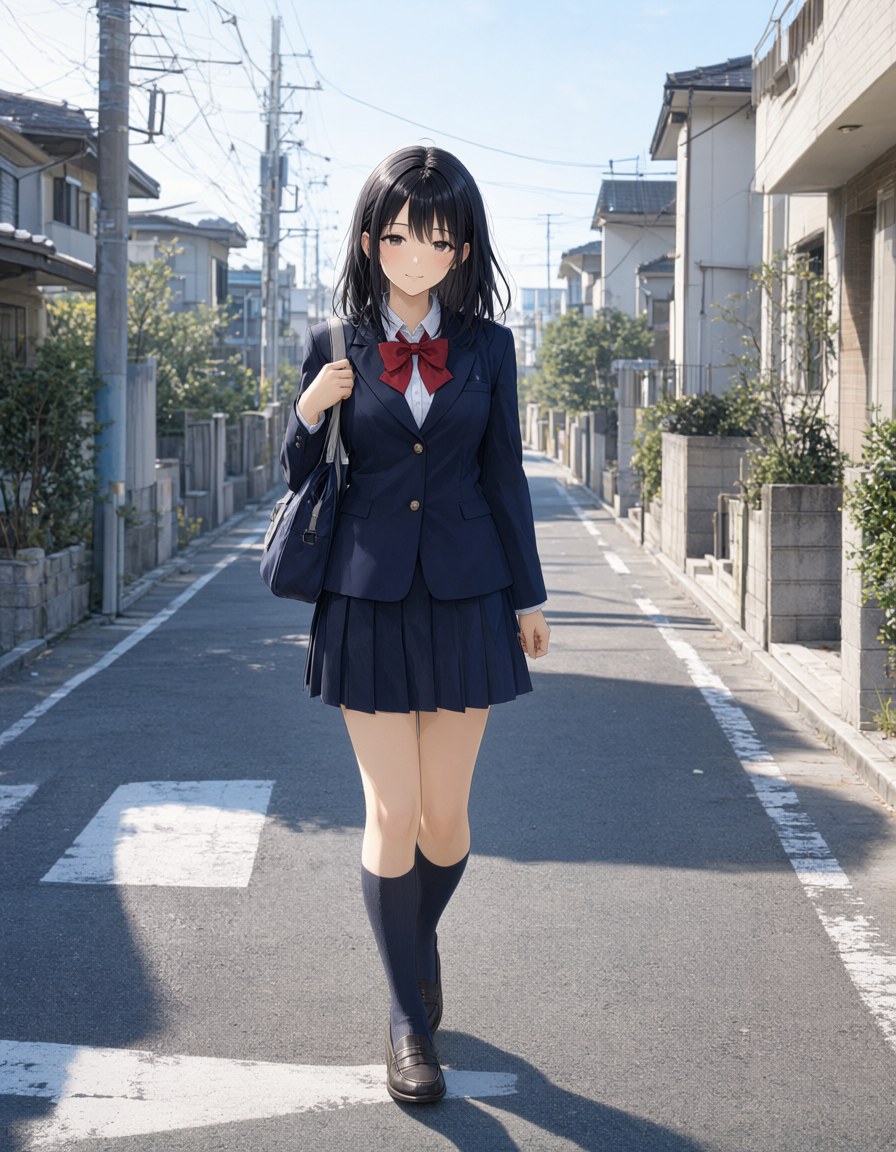
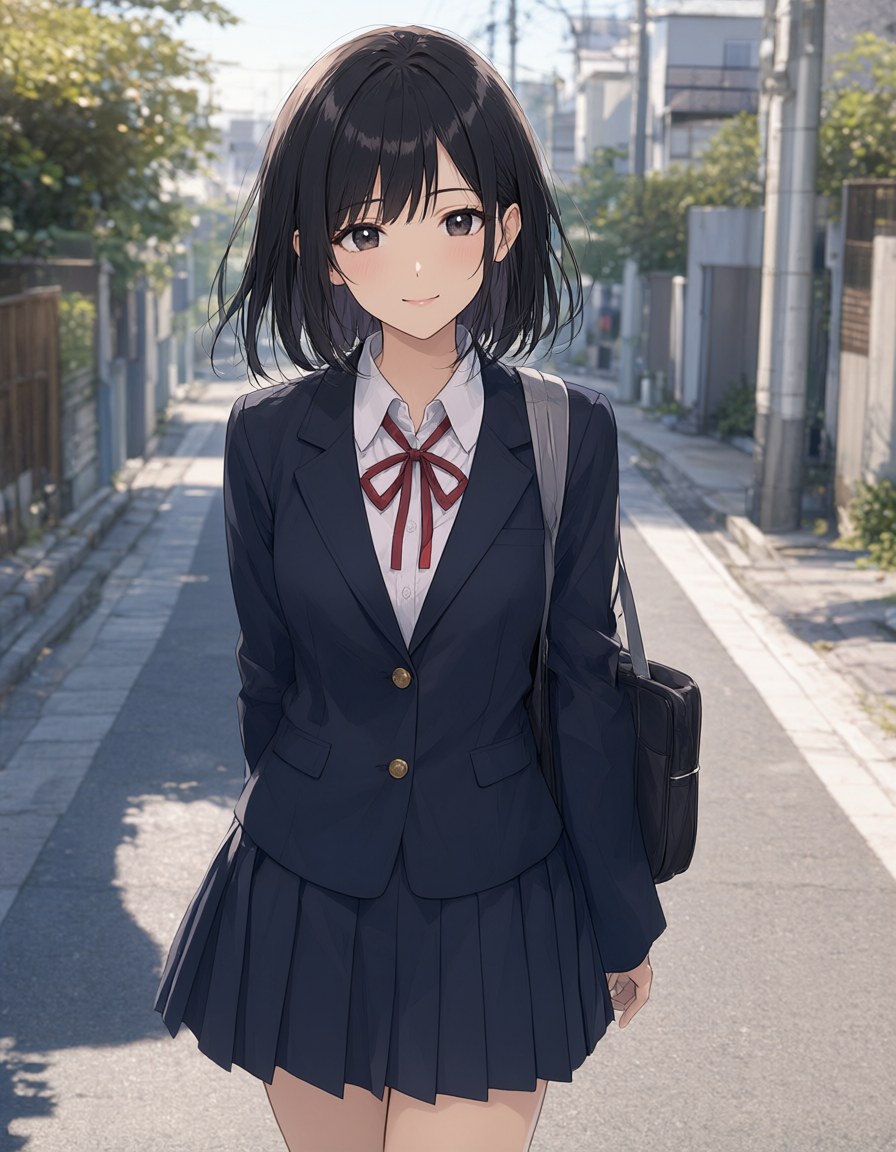
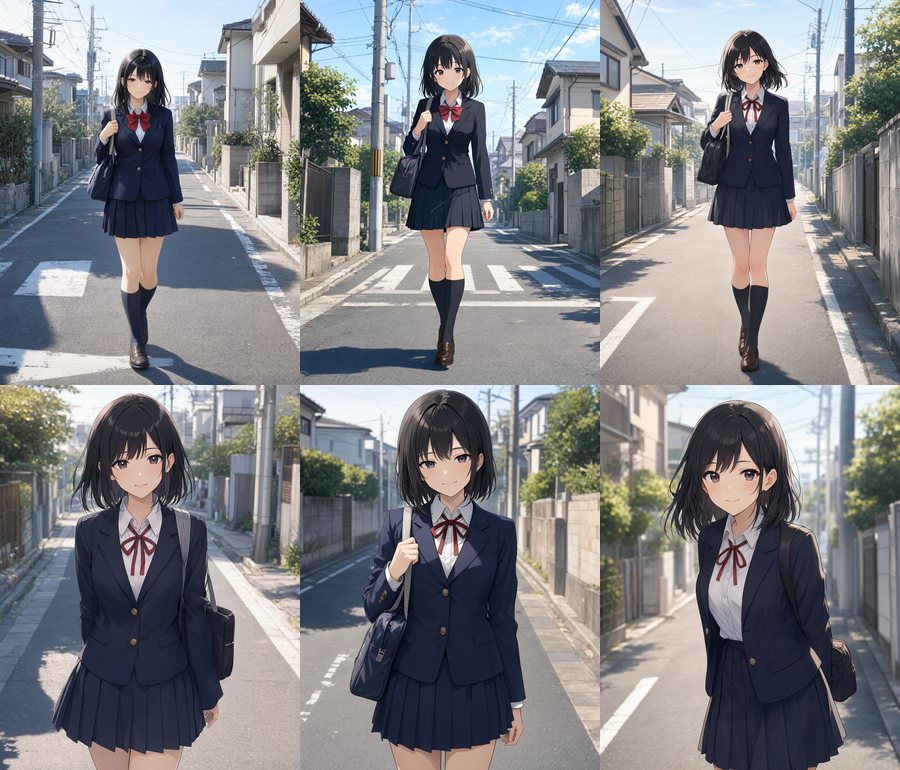
入力したプロンプト全文(アニメ)
引き:
anime style illustration, wide shot, full body, a fictional Japanese woman age 20, clearly an adult, wearing a school-uniform-style outfit: navy blazer, white shirt, red ribbon, knee-length navy pleated skirt, shoulder-length black hair, gentle smile, carrying a shoulder bag, fully clothed, modest, walking on a quiet residential street during a sunny morning commute, natural light, houses, utility poles, crosswalk接写:
anime style illustration, close-up portrait of the face and shoulders, a fictional Japanese woman age 20, clearly an adult, wearing a school-uniform-style outfit: navy blazer, white shirt, red ribbon, knee-length navy pleated skirt, shoulder-length black hair, gentle smile, carrying a shoulder bag, fully clothed, modest, looking at the viewer, on a quiet residential street during a sunny morning commute, natural light, shallow depth of fieldネガティブ: なし(CFG 1 のため無効)
文字の描画
公式が強みに挙げる文字の描画を、日本語の看板、英語のポスター、日本語の手書きノートの3種類で試しました。解像度は 1024×1024、seed は 1001 と 2002 です。生成した画像を拡大して、1文字ずつ確認しています。
日本語の看板
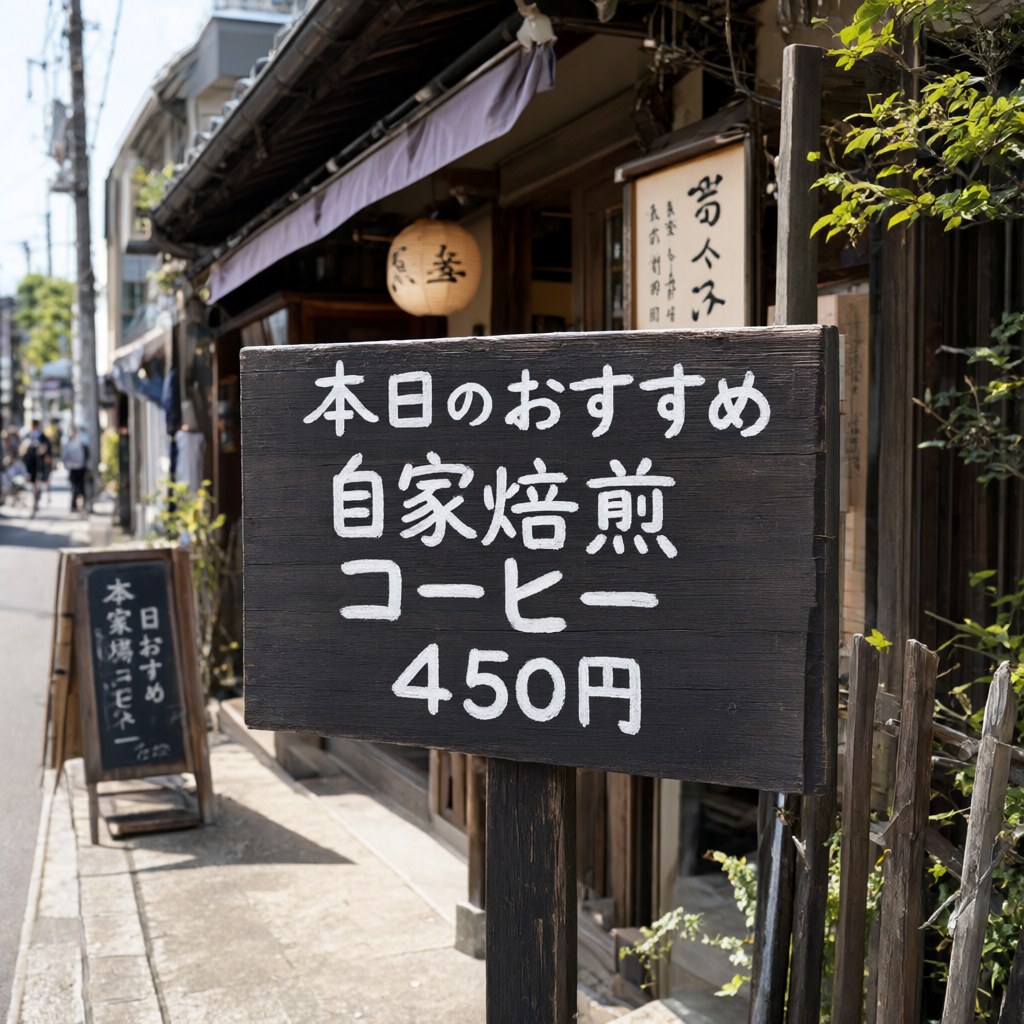
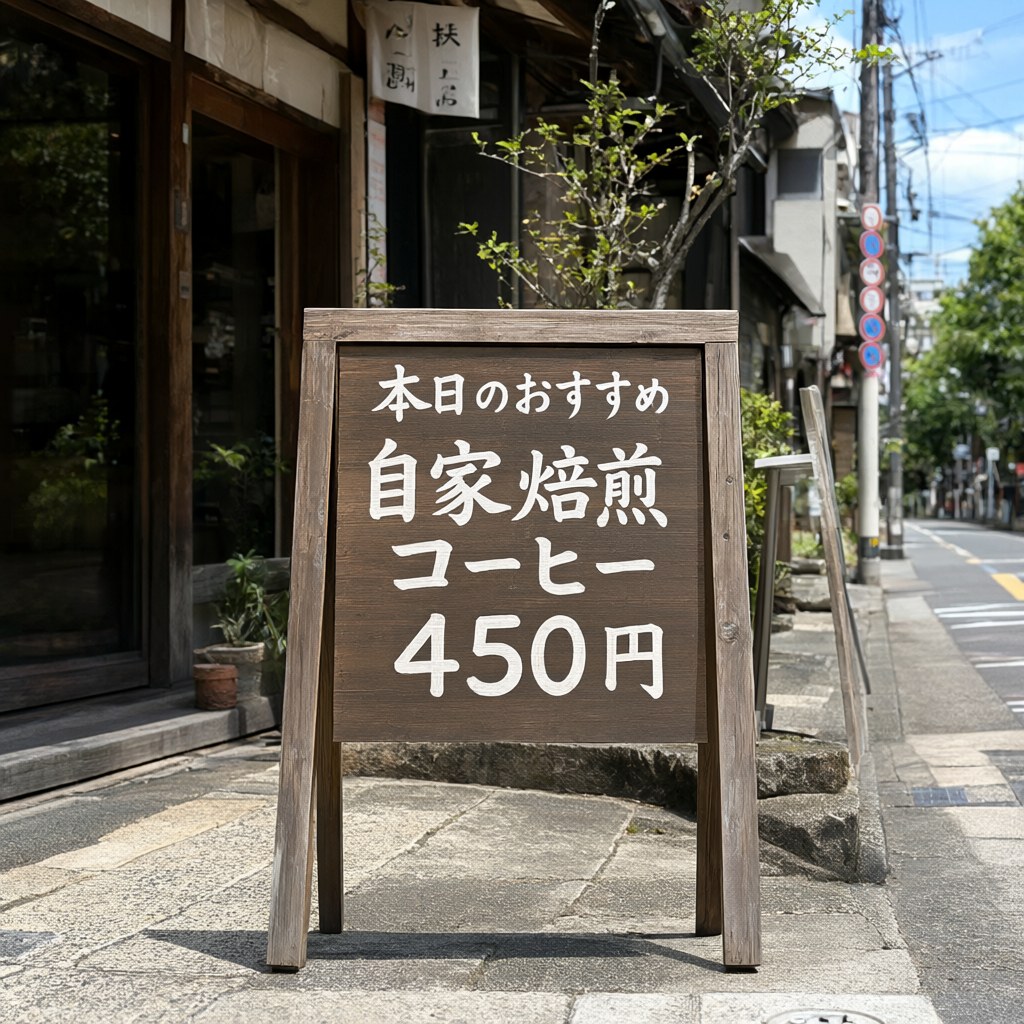
看板の「本日のおすすめ」「自家焙煎」「コーヒー」「450円」を、2枚とも正しい文字で描いた。背景の小さな看板の文字は読めない。
入力したプロンプト全文
プロンプト:
photo of a wooden standing sign in front of a small Japanese cafe on a sunny street. The sign has neat hand-painted Japanese text in three lines: "本日のおすすめ", "自家焙煎コーヒー", "450円". natural lightネガティブ: なし(CFG 1 のため無効)
英語のポスター
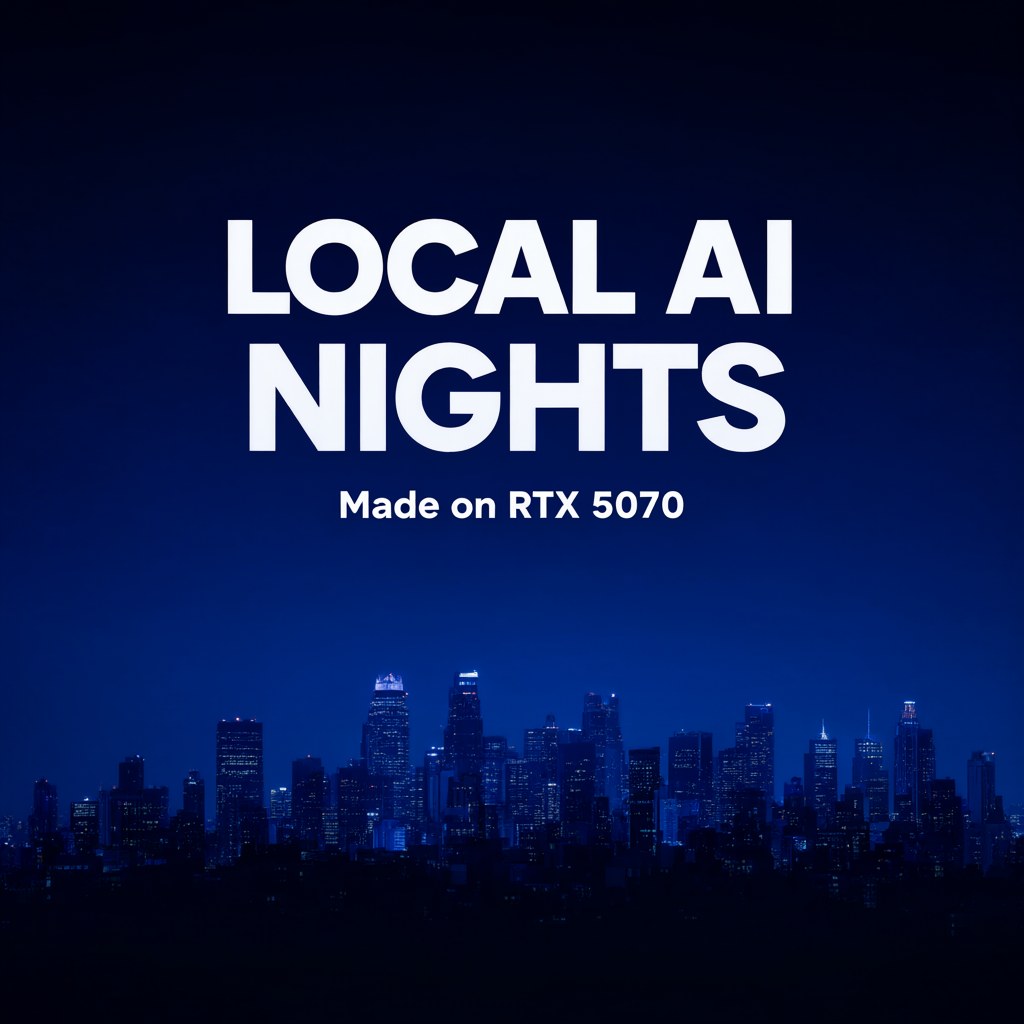
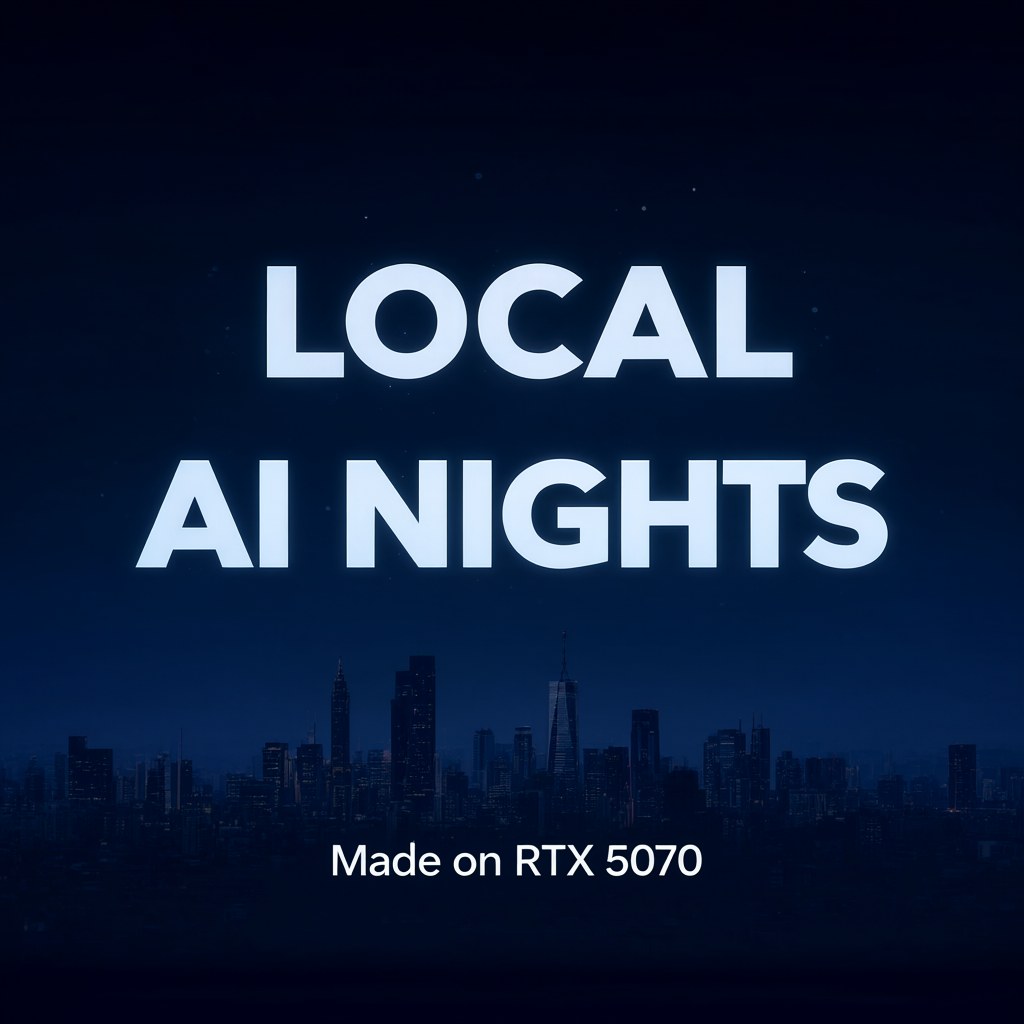
英語の「LOCAL AI NIGHTS」「Made on RTX 5070」を、2枚とも綴りの誤りなく描いた。
入力したプロンプト全文
プロンプト:
a minimalist movie poster with a dark blue background and a glowing city skyline. Large bold title text "LOCAL AI NIGHTS" at the top, and smaller text "Made on RTX 5070" at the bottomネガティブ: なし(CFG 1 のため無効)
日本語の手書きノート
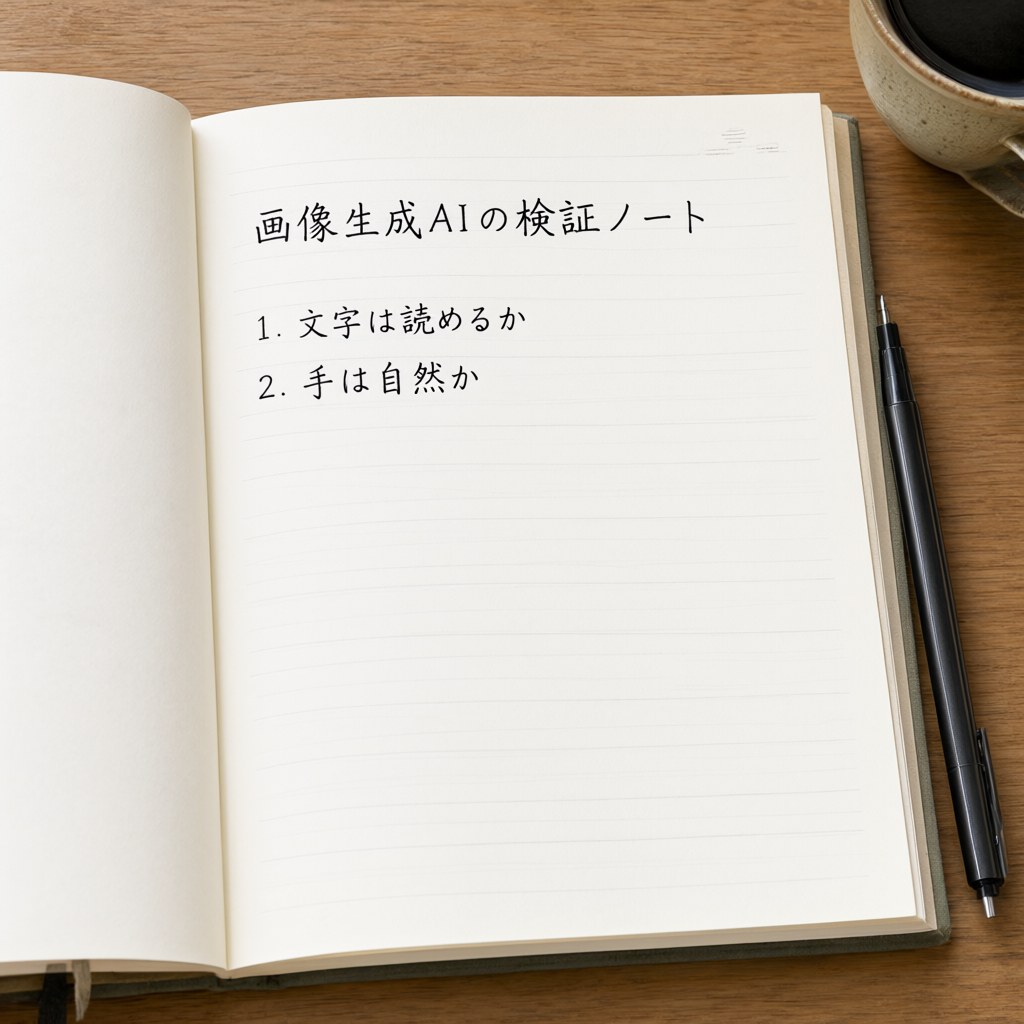
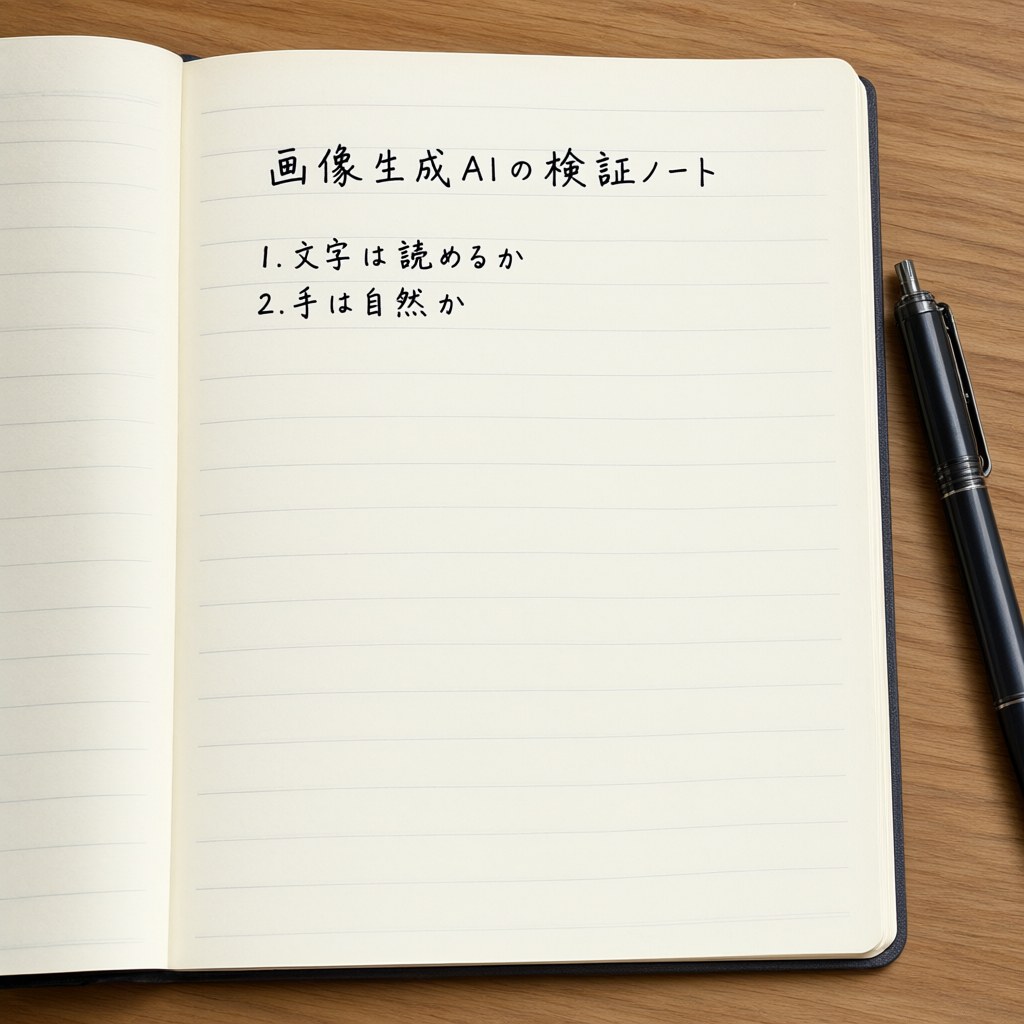
手書き風の「画像生成AIの検証ノート」「1. 文字は読めるか」「2. 手は自然か」を、2枚とも正しい文字で描いた。
入力したプロンプト全文
プロンプト:
top-down photo of an open notebook on a wooden desk. The page has neat handwritten Japanese text: "画像生成AIの検証ノート" as the title, and below it "1. 文字は読めるか" and "2. 手は自然か". a pen beside itネガティブ: なし(CFG 1 のため無効)
画像の編集
上の実写の接写(seed 1001)を元画像にして、公式の画像編集ワークフローと同じ構成で2種類の編集を試しました。服を変える指示と、背景を変える指示です。
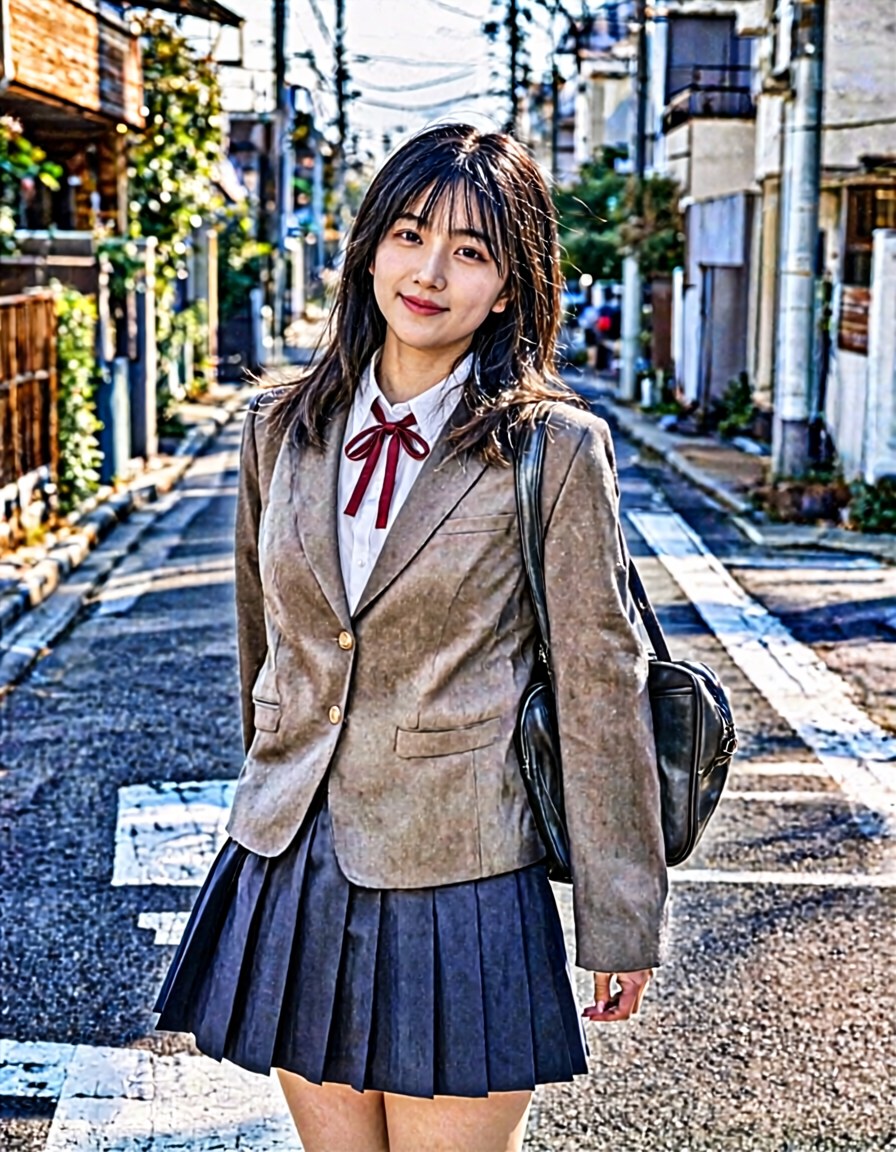
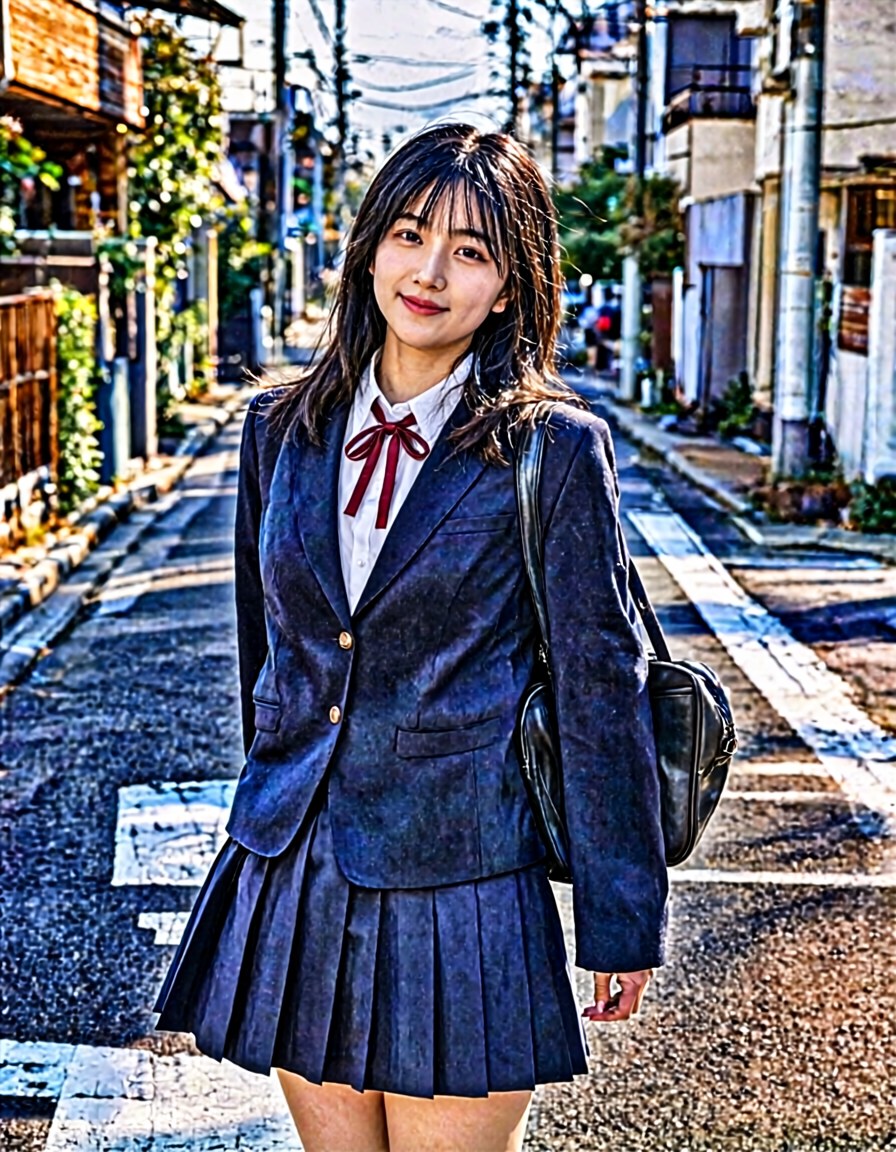
- 元画像の人物・構図・背景は保たれたが、服はニットのカーディガンではなくベージュのブレザー風になった。
- 画像全体のコントラストと彩度が強くなり、元画像より硬い印象になった。
- 背景は夜の商店街に変わらず、元の昼の住宅街のままだった。指示は反映されなかった。
人物と構図が保たれる点は編集モデルらしい動きです。ただ、今回の条件では、指示どおりの変更はできませんでした。公式の編集用ワークフローは、初期設定でプロンプト拡張(別の 9.5GB のモデル)を使う構成で、今回はそれを入れていません。この違いが結果に影響している可能性がありますが、確かめてはいません。
入力した指示の全文
服の変更:
Change the navy blazer to a soft beige knit cardigan. Keep her face, hair, pose and the background unchanged.背景の変更:
Change the background to a rainy shopping street at night with glowing shop signs and wet pavement. Keep her face, hair, clothes and pose unchanged.ネガティブ: なし(CFG 1 のため無効)
既存モデルとの比較
人物の生成は、実写系9モデル・アニメ系6モデルの比較記事と同じ条件です。その結果と並べると、次のようになります。
| モデル | 1枚の秒数 | 接写の効き方(実写) | 文字の描画 |
|---|---|---|---|
| Qwen-Image-2.1(int8) | 約50 | 3枚とも膝上〜太もも上 | 日本語・英語とも正確(今回の3種類) |
| Z-Image Turbo | 約14 | 3枚とも胸上の顔アップ | 未検証 |
| Krea 2 Turbo | 約23 | ほぼ効かず膝上 | 未検証 |
| RealVisXL V5.0 | 約9 | 3枚中2枚が胸上 | 未検証 |
人物を速く、構図どおりに作る用途では、Z-Image Turbo や SDXL 系のほうが扱いやすい結果でした。Qwen-Image-2.1 が向いているのは、看板・ポスター・手書きメモのように、画像の中に正しい文字を入れたい場面です。他のモデルの文字描画は今回は試していないので、優劣は断定しません。
分かったこと
VRAM 12GB の GPU でも、int8 版と ComfyUI v0.37.0 以降の組み合わせなら動きます。本体(7.26GB)とテキストエンコーダー(9.35GB)を int8 版にしたところ、RTX 5070 での生成中の VRAM は約10.2GB で、残りは約2GB でした。bf16 版は本体だけで14.2GB あり、12GB の GPU には載りません。ComfyUI が v0.36.0 以前の場合は、まず v0.37.0 以降に上げる必要があります。
文字の描画は、今回試した範囲では非常に正確でした。漢字・ひらがな・カタカナ・数字・英字の混ざった文を、2つの seed とも正しく描きました。ロゴやポスター、看板の画像を作る用途で試す価値があります。
人物の画角の指定は効きにくい傾向でした。close-up と書いても、実写・アニメとも膝上の構図になりました。顔のアップが欲しい場合は、別のモデルで作るか、切り出して使う方法を検討してください(後者は未検証)。
検証の限界
人物は各画角3枚、文字は各2枚、編集は各1枚だけの検証です。設定は公式ワークフローの既定値のみで、ステップ数やプロンプト拡張を変えた場合は試していません。モデルカードの例は40ステップですが、今回は ComfyUI 公式ワークフローの25ステップを使いました。
人物・背景・看板の店名はすべてAI生成の架空のものです。ライセンスは非商用限定のため、この記事の画像は評価目的の作例として掲載しています。