画像生成AIモデルを公平に比較する方法|プロンプト・設定・記録項目
同じプロンプトを入れたのに、片方だけ人物の顔や構図が崩れた。それはモデルの性能差だけでなく、入力形式や推奨設定の違いかもしれません。共通条件のテストと各モデルの推奨条件のテストを分け、実写・二次元の差を読み違えない比較手順を整理します。
先に比較の問いを一つ決める
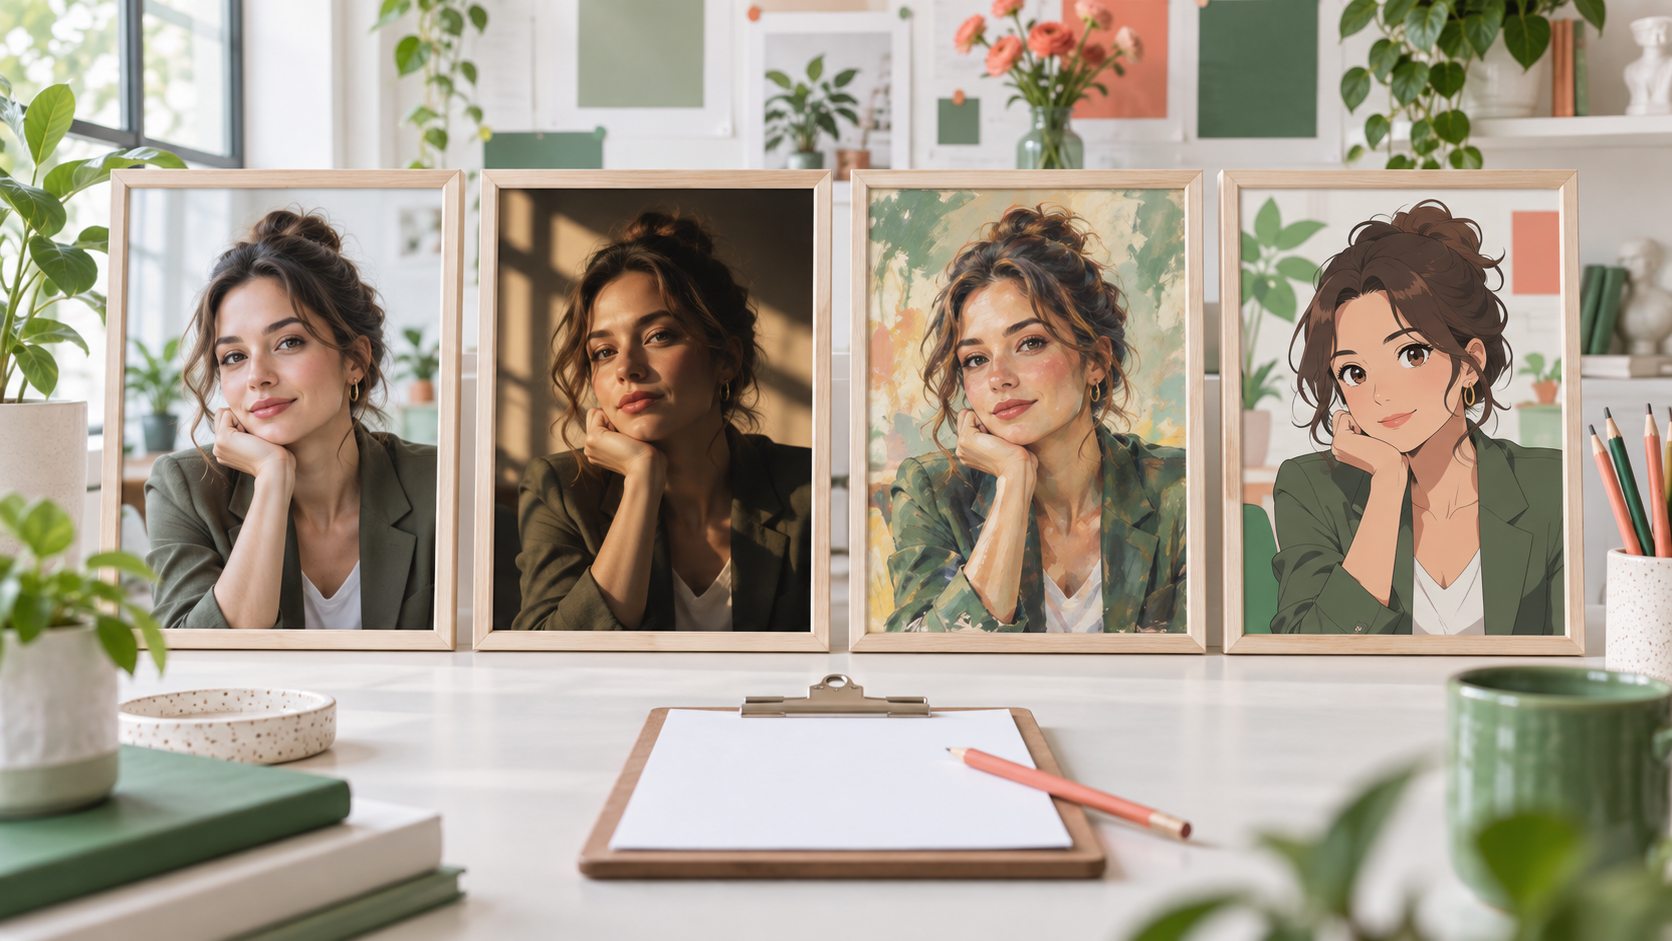
例:「成人の架空女性を、胸から上のポートレートとして、自然な窓光で描くと、実写系チェックポイントごとに顔・肌・背景の表現はどう違うか」。モデルランキングを作るより、読者が選択に使える問いの方が観察項目を決めやすくなります。
共通プロンプトを作る
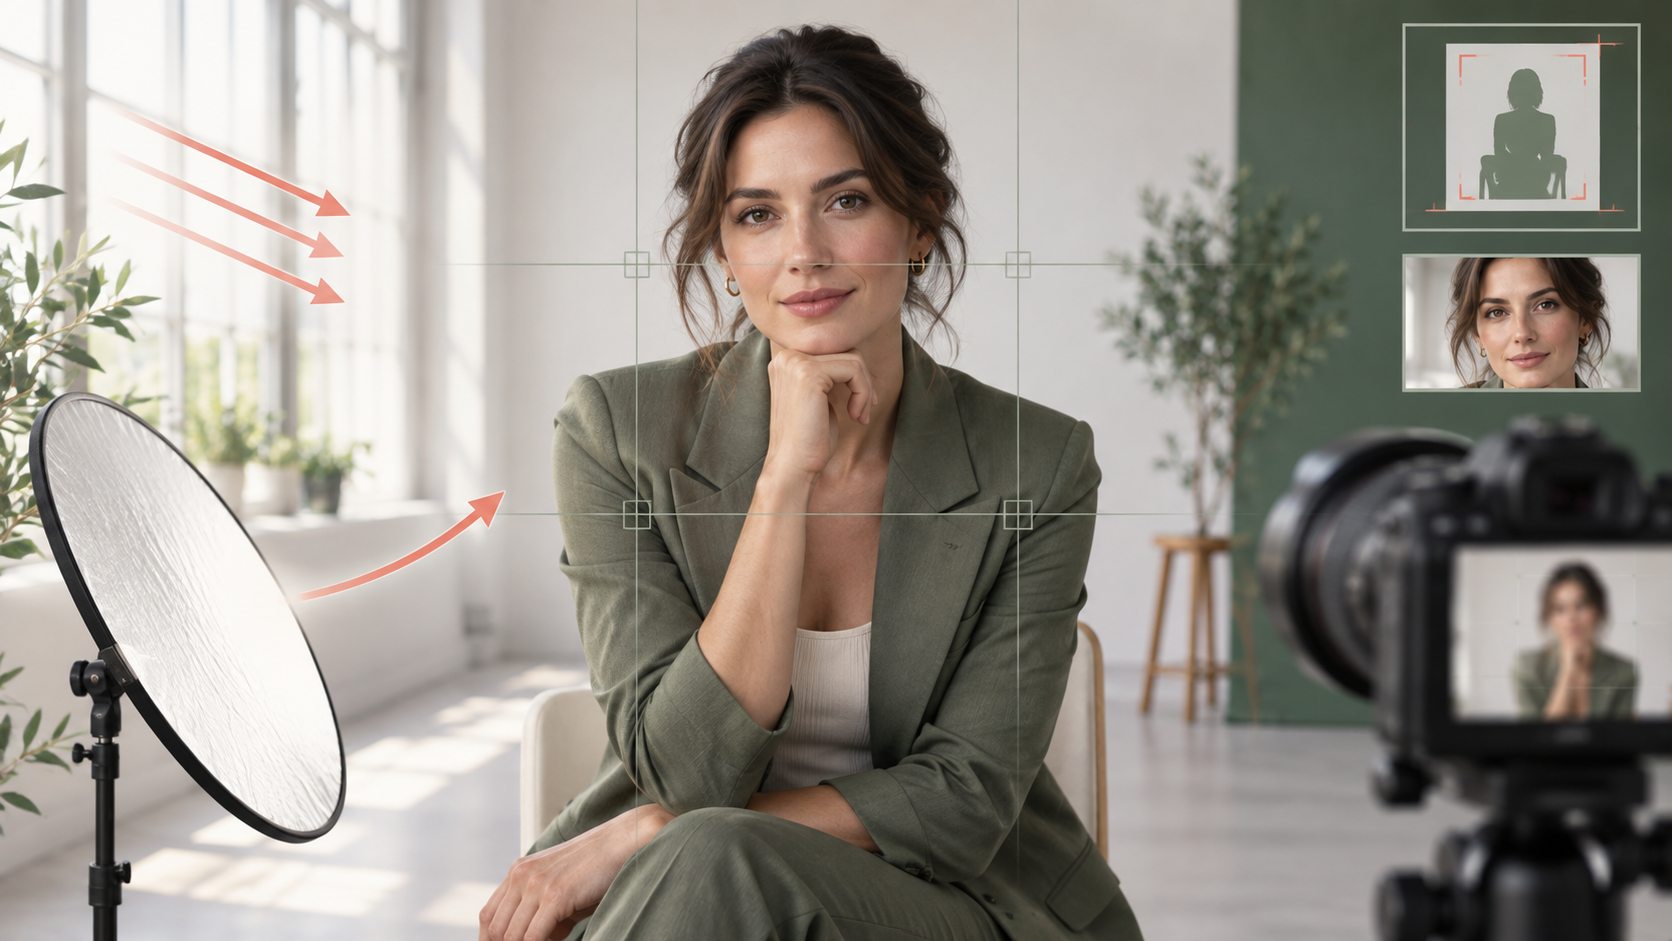
人物の成人設定、髪・衣装、表情、姿勢、場所、画角、光など、意味の核を固定します。写真風と二次元を比べる場合は、意味の核は同じに保ちつつ、style指定とタグ/自然文の書き方をモデル系統に合わせて別バージョンにします。
A portrait of a fictional adult woman in her early thirties,
with dark shoulder-length hair, wearing a navy jacket,
calm expression, seated beside a large window.
Chest-up framing, soft daylight from camera left,
simple background, subject centered.
この文章は比較用の設計例です。実際に各モデルで生成したプロンプトや、特定のモデルで有効と確認した設定ではありません。
「同じ入力」と「推奨設定」を別々に試す
| 実験 | 合わせるもの | 答える問い |
|---|---|---|
| 共通プロンプト | 意味内容、画角、乱数seedを固定可能ならseed | 同じ指示をモデルがどう解釈するか |
| 各モデルの推奨条件 | 人物設定と狙う画面。sampler等はモデル推奨に沿う | 各モデルを普段の使い方に合わせた時の結果 |
異なる系統ではseedの再現性やCFG・stepsの意味が揃わないことがあります。モデルカードとworkflowの推奨設定を記録し、設定を同一にしたことだけを公平性の根拠にしません。
1枚の偶然を結論にしない
小さく始めるなら、比較対象ごとに同条件で複数枚作り、各出力を並べます。生成回数を少なくした場合は探索的な観察と明記し、モデル全体の再現性や優劣に広げないようにします。seedを固定できる場合も、そのseedに限った結果です。
画像と一緒に残す記録項目
| 項目 | 記録する内容 |
|---|---|
| 識別情報 | モデル名・正確な版・配布元URL・確認日・ライセンス確認先 |
| 設定 | UI/Workflow、解像度、sampler、scheduler、steps、CFG、seed |
| 追加要素 | LoRA、ControlNet、VAE、顔修正、アップスケールの有無 |
| 出力の観察 | 人物設定、表情、手、衣装、光、構図、背景の指示一致 |
| 運用性 | 実測した場合のみ生成時間、VRAM、設定難度を記録 |
点数を付けるなら、各項目を分け、採点基準と画像枚数を併記します。単一の総合点だけで「一番いいモデル」と言い切りません。
モデル情報を確認するリンク
- Hugging Face Diffusers: guidance scale, negative prompts and seeds
- RealVisXL v5.0 model card
- Z-Image-Turbo model card and workflow
- ComfyUI: model types and loading
そのまま使える記録テンプレート
比較を始める前に、次の項目を表計算シートやメモへコピーしておくと、後から結果を追いやすくなります。
比較日:
モデル名・正確な版:
モデル配布元・ライセンス確認先:
UI / workflow:
解像度・sampler・scheduler・steps・CFG:
seed / 枚数:
追加要素(LoRA / VAE / ControlNet / upscale):
共通プロンプト:
指示との一致(人物 / 表情 / 衣装 / 構図 / 光 / 背景):
生成時間・VRAM(実測した場合のみ):
今回の条件で気づいたこと:
比較の限界:
実写風と二次元を比べる場合は一つの順位表に混ぜず、まず画風ごとに比較します。画質、指示追従性、速度、導入のしやすさは別々に記録し、用途に合うモデルを選びます。